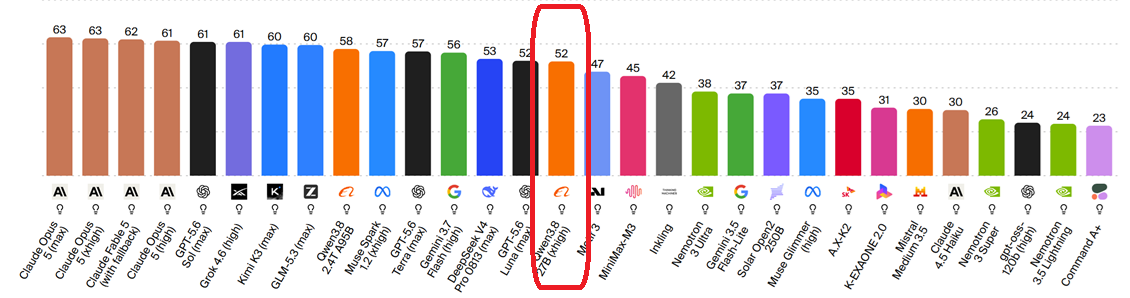
최근 로컬 AI 코딩 에이전트 앱 LM Studio Bionic에 Qwen 3.8 27B Q8 모델을 얹어서 프로그래밍 작업에 애용하고 있다.
(로컬 AI이므로 전기료를 제외하면 토큰 비용이 없는 무료이다.)
처음에는 아이디어로만 가지고 있던 새로운 기능을 구현하는 데 주로 사용했고, (소형 LLM을 활용한 로컬 자동 코딩 : https://ghts.tistory.com/211), 지금은 기존 코드에서 버그를 찾아내는 데 주로 사용하고 있다.
LM Studio Bionic이 상당히 무겁고 느린 데다가, Qwen 3.8 27B 도 과추론을 일삼는 특성이 있어서, 2개의 조합은 매우 느리지만, 작업이 확실하고 깔끔하게 마무리 되는 특성 때문에 계속 사용하고 있다.
잠들기 전 AI에게 버그를 찾으라고 명령을 내린 후, 자고 일어나 보면 밤새 AI가 작업해서 버그 보고서 작성을 마친 상태이다.
이렇게 잠든 시간을 활용하면, 느린 속도를 어느 정도 보완할 수 있다.
무료 중소형 LLM모델이 기억도 가물가물한 오래된 코드 뭉치에서 버그를 찾아내는 것을 보면 감탄을 금할 수 없다.
AI가 찾아낸 버그를 수정하다보니, 거의 변동이 없던 깃허브 저장소에 커밋이 갑자기 증가했다.
(https://github.com/ghts/ghts/graphs/commit-activity)

GPU 1장에 다 들어가는 27B에 불과한 소형 모델로 토큰 비용 지출 없이 이 정도 작업이 가능하다는 게 놀라울 따름이다.
앞으로 얼마나 많은 변화가 올 지 가늠도 안 된다.
'프로그래밍' 카테고리의 다른 글
| 소형 LLM을 활용한 로컬 자동 코딩 (Qwen 3.8 27B) (0) | 2026.08.25 |
|---|---|
| RStudio에서 대입 기호(<-) 간편하게 입력하기 (0) | 2023.09.23 |
| Go언어 내장형 SQL 데이터베이스 (0) | 2022.12.19 |
| IntelliJ GoLand에서 한글 함수 이름 문제 해결. (0) | 2022.09.23 |
| 한국투자증권 REST API (2) | 2022.07.07 |